S2 · HYPOTESETESTING
Hypotesetesting i S2: velg riktig hale og begrunn svaret
En hypotesetest sammenligner dataene med en presis nullmodell. Du trenger både riktig standardfeil, riktig hale og en konklusjon som sier hva testen faktisk gir grunnlag for.
Hva viser Udirs eksempelsett?
I REA3062 (S2), oppgave 6 på side 11, testes en mistanke om for lav gjennomsnittlig fyllemengde. Fire viste beregninger har ulike sentre eller standardavvik. Eleven skal begrunne hvilken som passer til testen, og bruke 5 % signifikansnivå. Finn originalsettet i Udirs katalog, og les også innledningen. Se felles regler om hjelpemidler.
Start med spørsmålet og forutsetningene
Vi bruker et eget flaskeforsøk. Før data samles inn, planlegger vi 16 tilfeldig utvalgte, uavhengige flasker fra samme produksjon. Fyllemengdene antas normalfordelte med ukjent forventning μ og kjent standardavvik σ = 8 ml. Dette er en modellforutsetning, ikke noe vi har beregnet fra de 16 flaskene.
Vi vil undersøke om forventningen er lavere enn 200 ml. Vi velger på forhånd H₀: μ = 200 mot H₁: μ < 200, og signifikansnivå α = 0,05. Dette er en ensidig test med nedre hale. Hvis påstanden i stedet er «minst 200 ml», kan H₀ formuleres μ ≥ 200; samme nedre test beregnes ved grensen μ = 200.
1. Gjennomfør testen
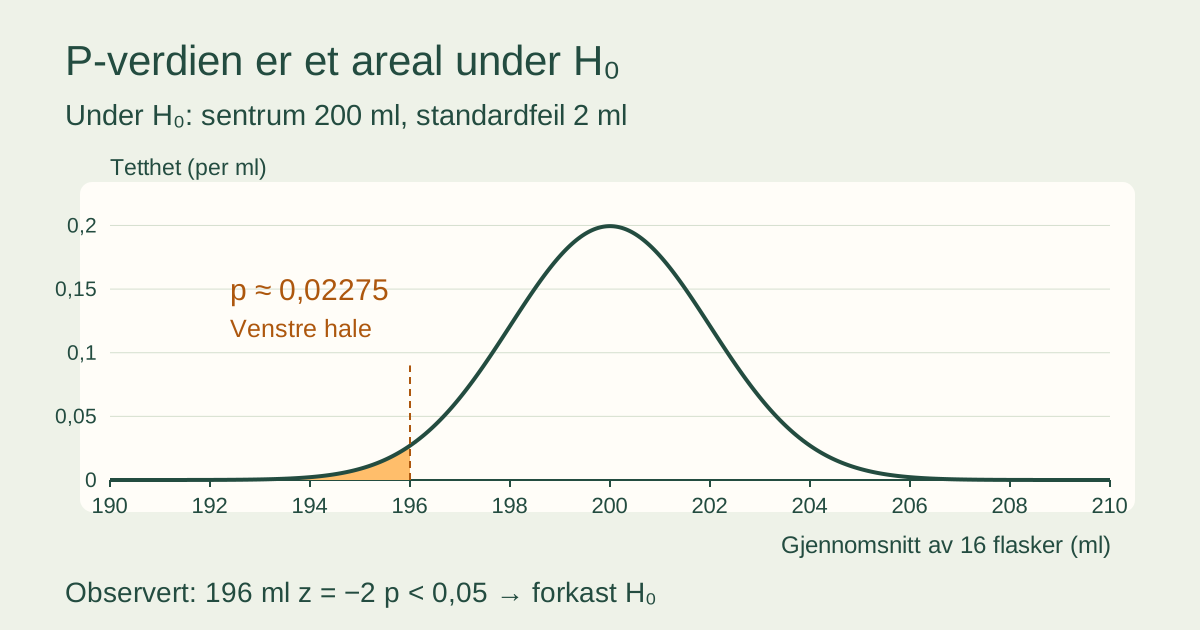
Det observerte gjennomsnittet er x̄ = 196 ml. Finn fordelingen til X̄ under H₀, standardiser resultatet, og gjennomfør testen. Bruk Φ(−2) ≈ 0,022750, der Φ(z) er arealet til venstre i standard normalfordeling.
Vis løsning og forklaring
Under H₀ har X̄ forventning 200 ml og standardavvik 8/√16 = 2 ml. Fordelingen er normal fordi enkeltmålingene er normalfordelte og uavhengige. Teststørrelsen er z = (196 − 200)/2 = −2.
Alternativet er lavere forventning, så minst like ekstremt betyr et gjennomsnitt på 196 ml eller lavere. P-verdien er P₀(X̄ ≤ 196) = Φ(−2) ≈ 0,022750. Siden 0,022750 < 0,05, forkaster vi H₀ på 5 %-nivå.
Under forutsetningene gir utvalget grunnlag for å konkludere med lavere forventet fyllemengde enn 200 ml. Det observerte avviket er −4 ml. Testen beviser verken hva årsaken er eller at hver flaske inneholder for lite.
Hvis nivået hadde vært valgt til 1 % før forsøket, ville samme resultat ikke gitt forkasting. Vi skal ikke velge nytt nivå etterpå for å få ønsket konklusjon.
2. Velg riktig beregning
Fire elever vil beregne p-verdien i forsøket over. Hvem bruker riktig fordeling, og hva er galt i de andre forslagene?
| Forslag | Sentrum (ml) | Standardavvik (ml) | Areal |
|---|---|---|---|
| A | 200 | 8 | Til venstre for 196 |
| B | 200 | 2 | Til venstre for 196 |
| C | 196 | 2 | Til venstre for 196 |
| D | 200 | 0,5 | Til venstre for 196 |
Vis løsning og forklaring
B er riktig. Nullmodellen er sentrert ved 200, og gjennomsnittet av 16 har standardavvik 2.
A bruker spredningen til én flaske og ville gitt omtrent 30,85 %. C flytter sentrum til det observerte gjennomsnittet og gir 50 %; testen skal beregne arealet under H₀. D deler σ på n i stedet for √n.
En test handler ikke bare om å finne en kalkulatorutskrift med liten sannsynlighet. Forklar hvilken tilfeldig størrelse kurven gjelder, hvilken hypotese som bestemmer sentrum, og hvorfor riktig hale er valgt.
3. Et annet utvalg og et annet spørsmål
I et nytt, separat forsøk er den samme nedre testen og 5 %-nivået valgt på forhånd. Nå er gjennomsnittet 199 ml fra 16 flasker. Bruk Φ(−0,5) ≈ 0,308538 og trekk en konklusjon.
Tenk deretter på en alternativ forsøksplan som før målingene undersøker ethvert avvik fra 200 ml. Hvilken alternativ hypotese og hvilke haler skal denne planen bruke? Hva ville p-verdien vært ved gjennomsnitt 196 ml?
Vis løsning og forklaring
For det nye utvalget er z = (199 − 200)/2 = −0,5. P-verdien i den nedre testen er 0,308538 > 0,05. Vi forkaster ikke H₀. Det er ikke det samme som å bevise at μ = 200; utvalget gir ikke tilstrekkelig grunnlag for forkasting med denne testen.
For ethvert avvik velges H₁: μ ≠ 200. Med teststørrelsen |Z| og observert z = −2 er minst like ekstremt Z ≤ −2 eller Z ≥ 2. Standard normalfordeling er symmetrisk, så p-verdien er 2 · Φ(−2) ≈ 0,045500. Det gir forkasting på 5 %-nivå, men p-verdien er dobbelt så stor som i den nedre testen.
Doblingen gjelder denne symmetriske, tosidige normaltesten. Den er ikke en universell regel for alle tester. Retningen skal aldri velges ut fra hvilken hale som etterpå gir lavest p-verdi.
Skriv en konklusjon som kan etterprøves
Oppgi hypotesene, modellen, utvalgsstørrelsen, standardfeilen, teststørrelsen, p-verdien og nivået. Avslutt med hva dataene gir grunnlag for i situasjonen. Ved 5 %-nivå kontrollerer en gyldig test risikoen for å forkaste en sann nullhypotese over gjentatte forsøk. Det betyr ikke at 5 % av dine konklusjoner nødvendigvis er feil.
Her var σ kjent. Hvis standardavviket i stedet er estimert fra et lite utvalg, kan du ikke uten videre bruke den samme eksakte normaltesten. Testmetoden og forutsetningene må da vurderes på nytt. Et stort utvalg reparerer heller ikke et skjevt utvalg eller avhengige målinger.
Repeter forskjellen mellom én måling og et gjennomsnitt · Fortsett med hypotesetesting i appen · Øv på rekker og rekursjon i S2.
Kilder og oppdatering
Kildehenvisningene gjelder Udirs eksempelsett hentet 16. oktober 2026. Oppgavenumre og sider er kontrollert i originalene. Våre modeller, illustrasjoner og øvelser er laget av Basic Matte og er ikke Udirs oppgaver eller offisielle løsningsforslag. Lenket historisk fagmateriale bygger på Basic Matte av Sverre H. Bautz.